Untitled
# 北大跑了 591 次 RLVR 训练,把「挑数据」这件事重新测了一遍
一句话摘要。RLVR 后训练里那些流行的数据策略,选样、加权、动态调配比,被放进同一套固定 GRPO 配方里做了 12 个匹配 seed 的对照,结论是**相对 uniform 采样全部没有可信增益**。而 GRPO 本身涨的 **+7.76** 分,是它们全部均值跨度(0.97)的八倍。
## 「数据策略」是怎么变成一个赛道的
要理解这篇在测什么,得先看 GRPO 的训练循环长什么样。RLVR 是用可验证奖励做强化学习,数学题答案对不对、选择题字母匹不匹配,verifier 能直接判,不需要训一个奖励模型。GRPO 的做法是每个 prompt 一次生成 K 条回答(业内叫 rollout,就是让模型自己答五遍),用 verifier 给五条打分,再拿组内均分当基线算相对优势。
这套循环里多出一个以前没有的自由。SFT 阶段数据是离线固定的,而 GRPO 每一步都得现采样。谁来决定哪些题值得花 rollout、哪些答案该进这次梯度、下一批从哪个域出题,这个在线决策就是 paper 里说的 data policy。
动机的源头是一个很干净的技术观察。一个 prompt 五条回答如果全对或全错,组内均值就等于各自分数,相对优势全为 0,这次更新在这些 token 上什么都不学。真正有信息量的是模型犹豫的那批题,五条里对错混杂、优势被拉得最开。有道理,谁不想知道那些五连败的题是不是白花了算力。
于是这条线上长出了一堆方法。DAPO 把全对全错的组直接丢掉,PODS 反过来在组内保留一组让奖励方差最大的子集,GFPO 按单 token 奖励挑五里之三,Advantage Reweighting 压住低概率 token 的贡献,PER 式加权反过来强调高意外样本,往域级别走还有 DUMP 的 UCB 与 teacher-student curriculum 按学习进度改采样分布。七篇论文,七个不同的改动位置。
## 但这些增益此前基本没法验证
问题不在方法,在验证方式。这类方法通常作为整条 RLVR 配方里的一个零件被端出来,同时被改动的还有底座模型、prompt 模板、verifier、rollout 预算和优化超参。涨了 3 分,其中多少来自数据策略说不清。同一个分数还能有两条用法,advantage 的绝对值既可以定义成连续的 loss 权重,也可以定义成硬筛选规则,两篇论文各自用一种,读者以为它们是一回事。
在线采样又叠了两层麻烦。某个题有没有用,取决于当前 policy 走到哪儿,这个信号既噪又内生。更麻烦的是噪声的量级,seed 之间的方差加上小基准集本身的测量噪声,常常和论文报出的方法差距同量级。还有一个更隐蔽的自由度藏在评测里,少测一个域或换一种加权,谁排第一可能就变了。
测量这件事的老规矩是,先量出仪器误差,再读被测对象。放到这里,是要先量出 seed 噪声和评测聚合能造成多大位移,再来读数据策略的差值。DataFlex-RL(arXiv 2609.06107,北大 × 国科大 × 上海算法创新研究院 × 中关村学院,Hao Liang、Mingrui Chen、Hengyi Feng、Meiyi Qiang 并列一作,Wentao Zhang 通讯)做的就是把这台仪器搭出来。
## 第一步是把「改了什么」和「用什么信号」拆成两栏
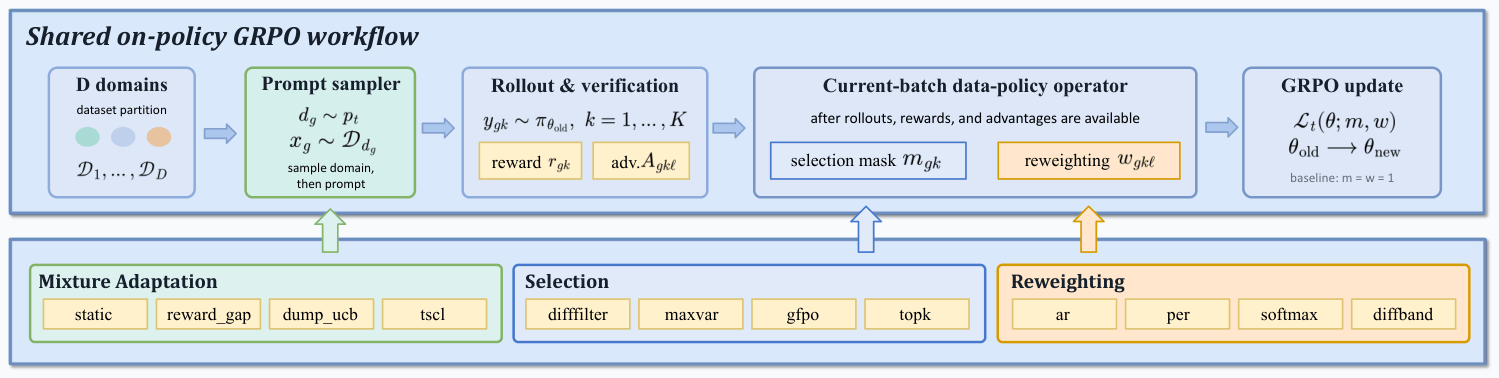
图 1 是全文最值得复用的东西。它先规定所有方法共享同一条主循环,题目按域切分、prompt 采样器出题、rollout 与验证、GRPO 更新,baseline 就是掩码和权重全取 1。三类策略只能在三个位置动手。
**Mixture adaptation 动手最早**,在下一批题采样之前改变各域概率 p_t(d),逐条回答的 loss 一个字都不改。**Selection 动手在 rollout 之后**,给每条回答一个 0 或 1 的掩码,没选中的贡献归零,而且它不做归一化,**实际参与优化的 token 数会变少**。**Reweighting 在同一个位置但动法不同**,回答全留,只把 token 权重 w 改掉,并且强制均值归一为 1,更新体积不变。
这一拆顺手解决了一个常见误解。选样看着像省算力,可它和加权都发生在生成之后,五遍回答早就跑完了,生成成本一分没省,被改变的只是进入梯度的 token 量。真要算总账,反而多花了 rollout 却没拿到等效的更新量。
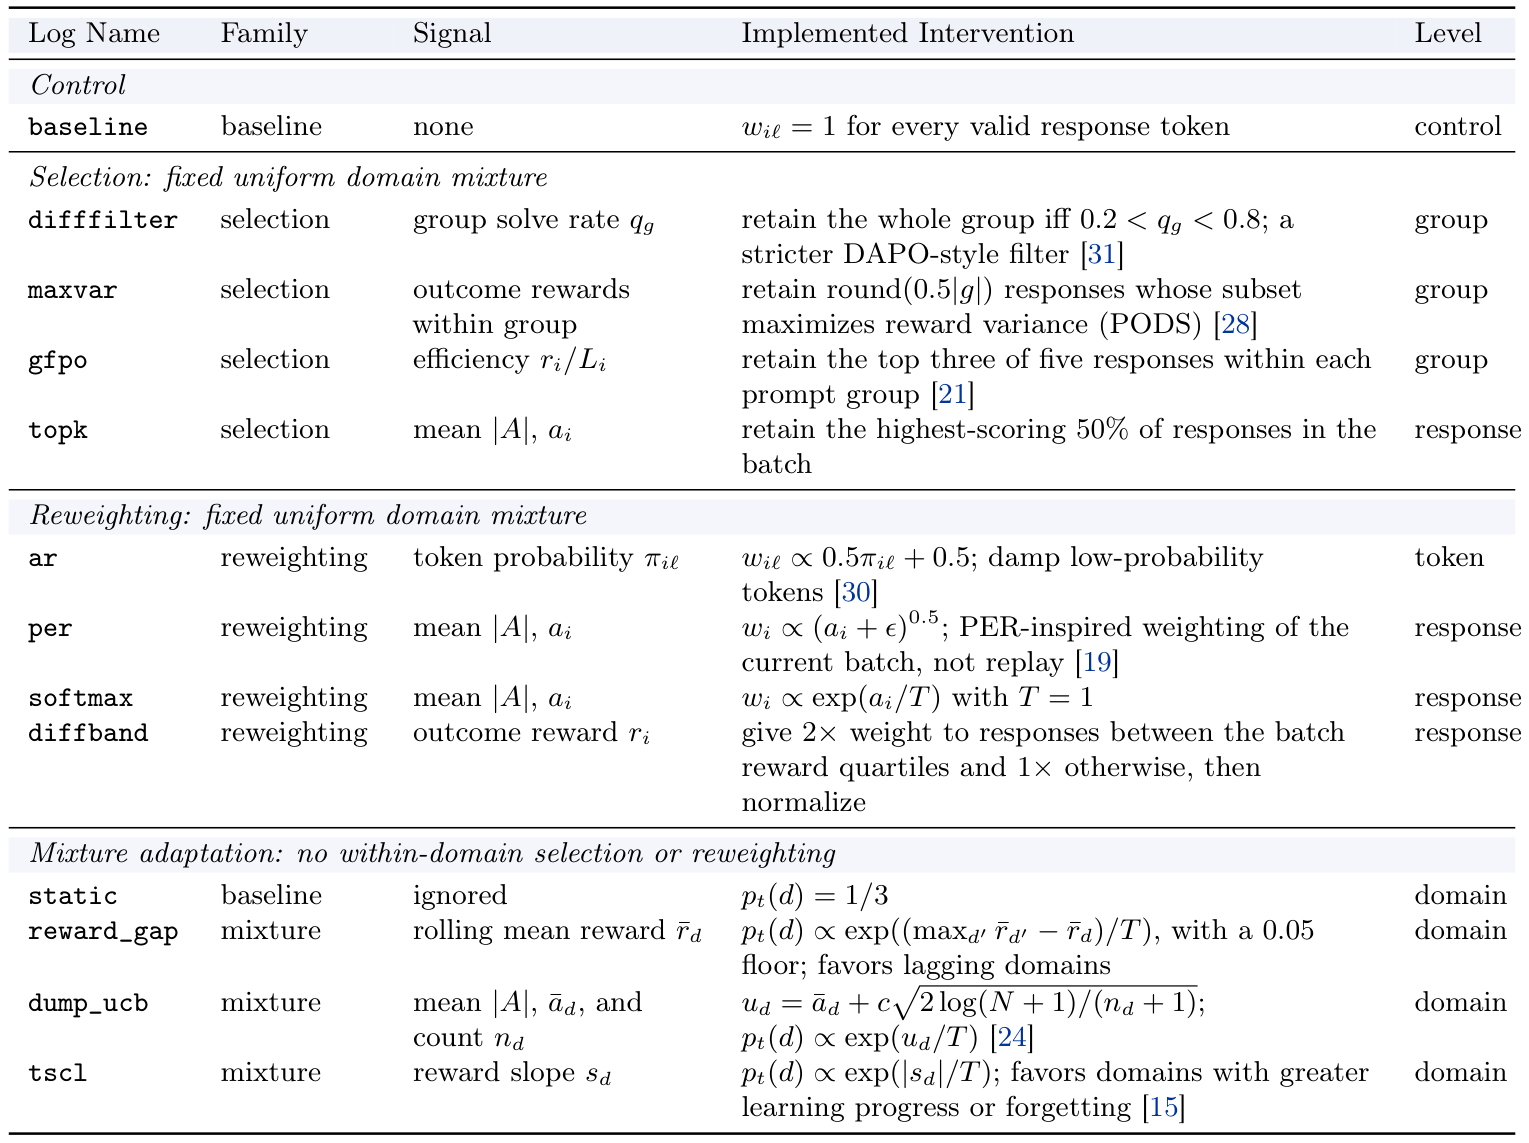
表 1 里藏着这套设计最锋利的地方。per、softmax、topk 用的是**同一个 signal**,都是每条回答的平均绝对优势 mean|A|,区别只在干预。前两个把分数摊成连续权重,topk 拿它做五留三的硬决策。同一个信号、两种动法并排跑,就能问出这个信号是用来加权还是用来筛选更合适,而以前的文献习惯把「信号有效」和「方法有效」一起报。
实验规模也摆在桌面上。591 个 run,主实验块是 13 配置 × 12 匹配 seed = 156 个 run,底座 Qwen2.5-7B-base。训练集 15,000 条 prompt,math、logic、science 三等分,math 用 math_dapo、DeepScaler、GSM8K 加 boxed-answer 校验,logic 是程序生成的 Knights&Knaves 配上 assignment checker,science 用 SciQ 选择题做精确字母匹配。统一 verl v0.5+、每题 5 rollout、KL 系数 10⁻³、prompt 1024、response 8192、300 步、确定性解码。评 12 项,五个数学集、四个逻辑集、三个科学集,Overall 先做域内平均再让三域等权。
还有两个容易被跳过的准备动作。跑任何 campaign 之前先做一次 calibration smoke test,用参考 checkpoint 验 boxed-answer 和选择题解析能不能被正确抓到。再拿 15,000 条训练 prompt 对 12 个评测集全量查重,结果是无精确匹配、无归一化匹配、13-gram Jaccard 没有一条超过 0.5。
## 比谁更强之前,先确认模型还有得多
这一步很朴素,但也最容易偷工减料。如果底座本身在 RL 下几乎不涨,那所有数据策略一起测不出差异,只能说明你挑错了考场。
| 底座 | Seeds | 未训练 | Uniform GRPO | Δ | 95% CI |
|---|---|---|---|---|---|
| Qwen2.5-7B-base | 12 | 42.01 | 49.77 | **+7.76** | [7.28, 8.25] |
| Llama-3.1-8B-base | 12 | 10.87 | 21.12 | **+10.25** | [7.75, 12.33] |
考场是对的。光靠统一配方,Qwen 涨 7.76,Llama 涨 10.25,两条线都在学。
## 主结果,八个配对区间没有一个排除零
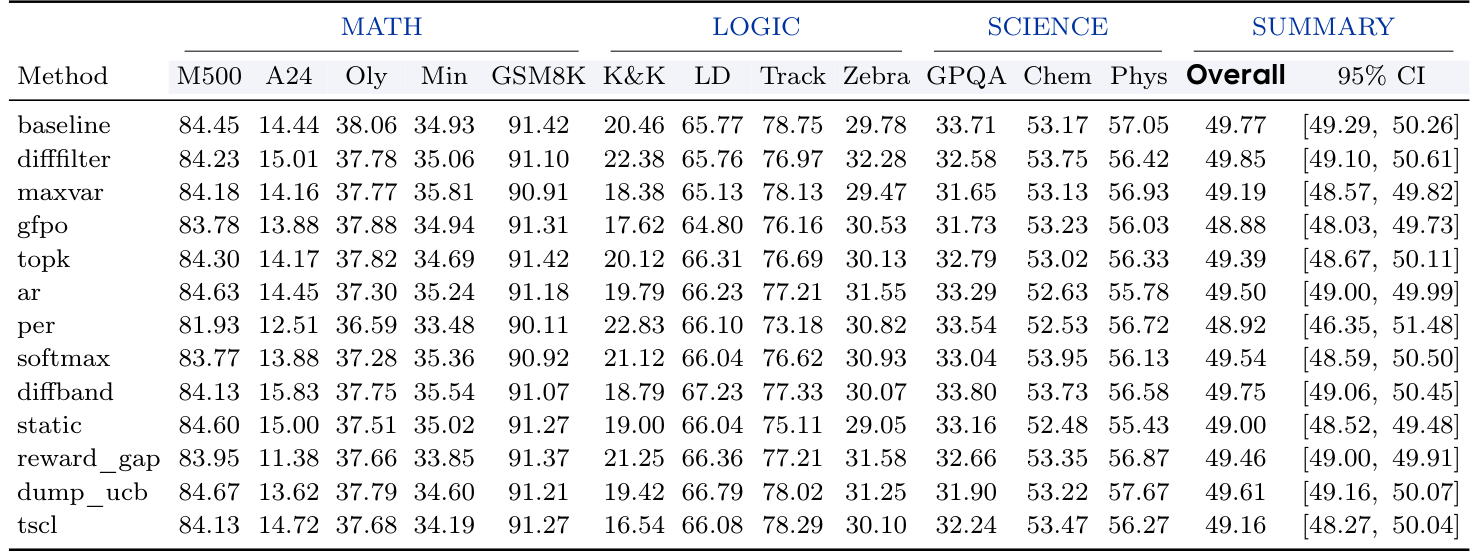
先看图里那一整片数字。差异没有堆在某一个域上,logic 上偏强的方法在 math 和 science 上并不跟着强,Overall 是三域真平均后的结果,不是被某一个 benchmark 拽出来的。
| 类别 | 方法 | Overall | 配对 Δ | 95% CI |
|---|---|---|---|---|
| baseline | uniform | 49.77 | — | — |
| selection | difffilter | 49.85 | **+0.08** | [−0.67, 0.82] |
| selection | maxvar | 49.19 | −0.58 | [−1.39, 0.23] |
| selection | gfpo | 48.88 | −0.90 | [−1.87, 0.08] |
| selection | topk | 49.39 | −0.38 | [−1.14, 0.38] |
| reweighting | ar | 49.50 | −0.28 | [−1.15, 0.60] |
| reweighting | per | 48.92 | −0.86 | [−3.28, 1.57] |
| reweighting | softmax | 49.54 | −0.23 | [−1.44, 0.98] |
| reweighting | diffband | 49.75 | **−0.02** | [−0.61, 0.57] |
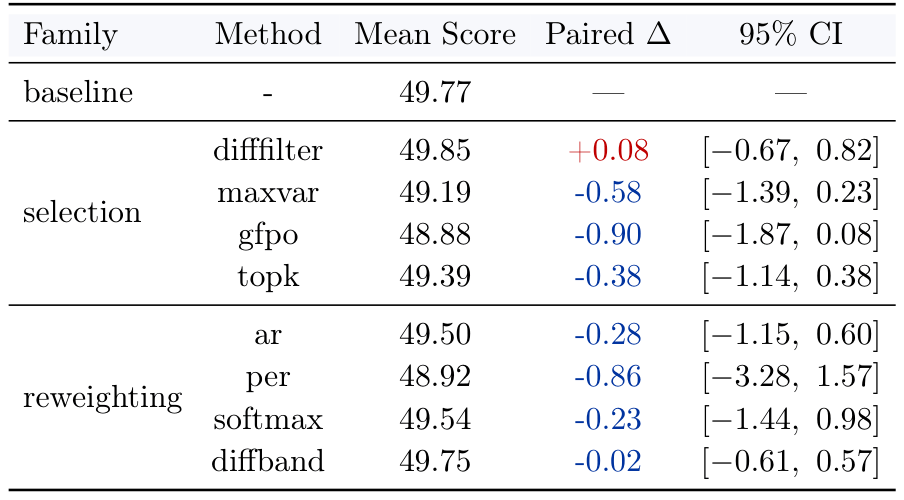
八个区间全跨零,最好的 +0.08 和最差的 −0.90 加在一起不到一分。九个均值首尾跨度 **0.97**,比 difffilter 自己那条区间的宽度 1.49 还窄,per 那条更是拉到 4.85。
到这里其实还剩一个更值得记住的现象。作者顺手做了 seed 数的对照,**原来 3 seed 子集里排第一的是 topk,补满 12 seed 之后均值最高变成 difffilter,而 topk 掉到了 baseline 以下**。同一批训练记录,两种 seed 数给出两个不同的冠军方案。我第一遍读到这里停了一下,因为我们平时看到的大量「A 方法比 B 高 0.5 分」,量级和这个翻面过程几乎相同。
Mixture 三兄弟的结果同构。固定等比混合 static 是 49.00,reward_gap +0.45 [−0.09, 1.00],dump_ucb +0.61 [−0.02, 1.25],tscl +0.16 [−0.61, 0.93]。三个点估计都是正的,三条区间也都含零,均值跨度 0.61。训练日志确认实际域比例确实被改写了,也就是说过程真的变了,最终精度没跟着变。
## 换个模型,结论站住了,但顺带暴露一个能把整批数据作废的坑
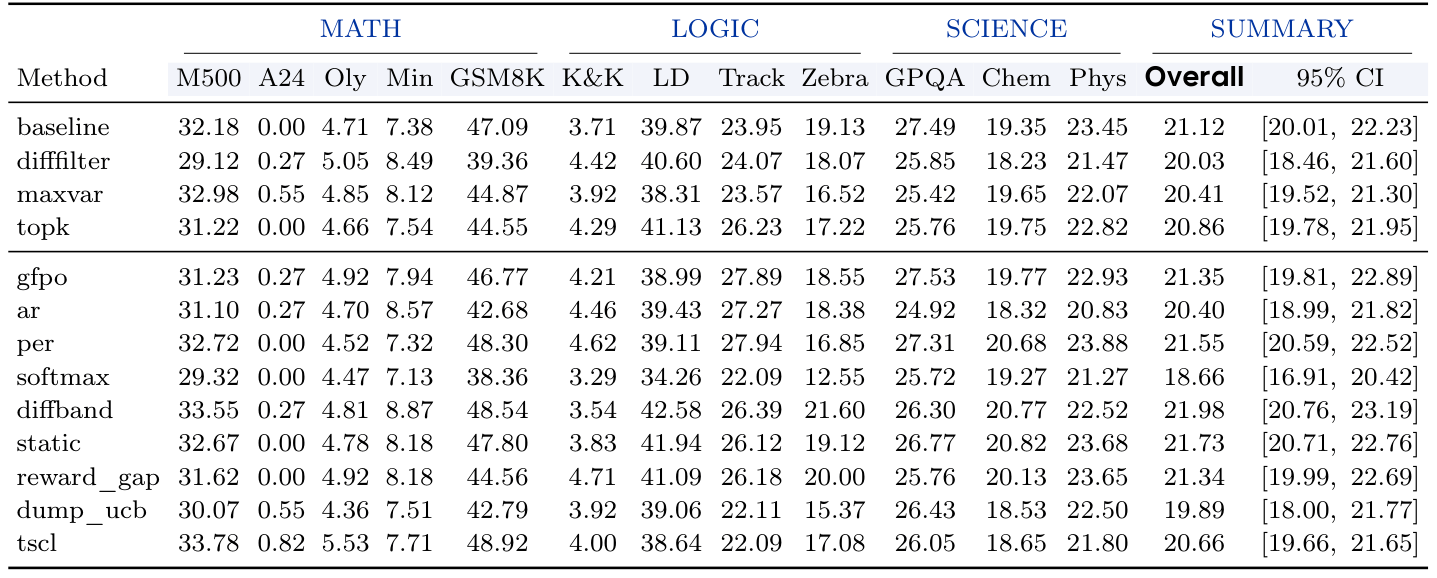
Llama 上 GRPO 本身涨得更多,10.87 到 21.12。三个原始 selector 的配对差是 difffilter −1.09、maxvar −0.71、topk −0.26,区间全含零。修正后的扩展把另外九个方法放到了同一分数尺度上,均值从 18.66(softmax)到 21.98(diffband),仍然挑不出共同赢家。
同一段里作者很轻地写了一句要紧的话。**之前那批 14–16 分的 Llama 结果全部作废**,原因是评测器会把不支持的数学任务静默记 0 分。这件事在 RLVR 里不抛异常,训练 loss 曲线一切正常,只有 benchmark 整块失真。前面提到的 calibration smoke test 就是为它准备的,现在你能看出那不是可选项。
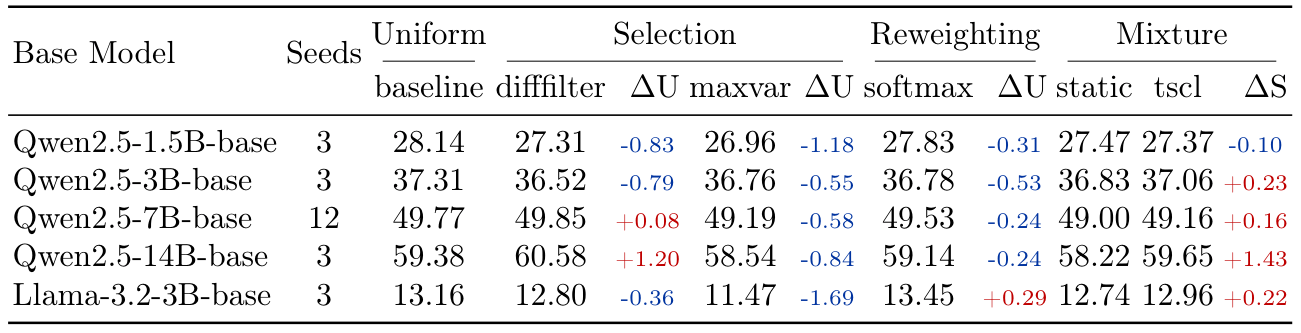
规模扫描覆盖 1.5B、3B、7B、14B 和 Llama-3.2-3B(除 7B 用 12 seed 锚点,其余三 seed)。符号是乱的。difffilter 相对 uniform 在 1.5B 是 −0.83、3B 是 −0.79,到 7B 变 +0.08、14B 变 +1.20;maxvar 五档全负(−1.18、−0.55、−0.58、−0.84、−1.69);tscl 相对自己的固定混合对照,只在 1.5B 略负 −0.10,其余四档为正。作者自己也标注了这行的用途,只用来看覆盖面和方向,不当独立显著性检验。
## 还有一个自由藏在「评哪些域」里
做到这里,训练侧的变量已经全锁住了,剩下的变量在评测汇总方式上。作者拿同一批 Qwen2.5-7B-Instruct run 重算了四种摘要,只换算法不动模型。
| 评测摘要 | 与 DB-12 的秩相关 ρ | 方法间极差 |
|---|---|---|
| DB-12(三域均衡) | 1.00 | 3.31 |
| Macro-12(逐 benchmark 等权) | 0.88 | 2.79 |
| Item-12(按题量加权) | 0.88 | 2.17 |
| Math-Heavy-6(五个数学集加 GPQA,无 logic) | **−0.33** | **0.90** |
丢掉 logic 域的六个集,把 topk 和 diffband 排进前二;三域均衡的十二集,第一名是 gfpo 和 difffilter。两套排名**负相关**,ρ = −0.33,Kendall τ = −0.28,方法极差同时从 0.90 涨到 3.31。而只要 12 项都保留,换成逐集等权或按题量加权,相关性都能稳在 0.88,留一法检验也在 0.78 到 0.98。分歧不是加权方式造成的,是被丢掉的那个域造成的。
原因在方法本身的域间取舍。diffband 在同一批 run 里 LOGIC 均值最高(59.0),SCIENCE 最低(44.2)。少测一个域,你测到的是一份不同的模型画像,而不是同一件事的更简洁版本。
## 那这些方法到底有没有效?机制对照给出的答案更细
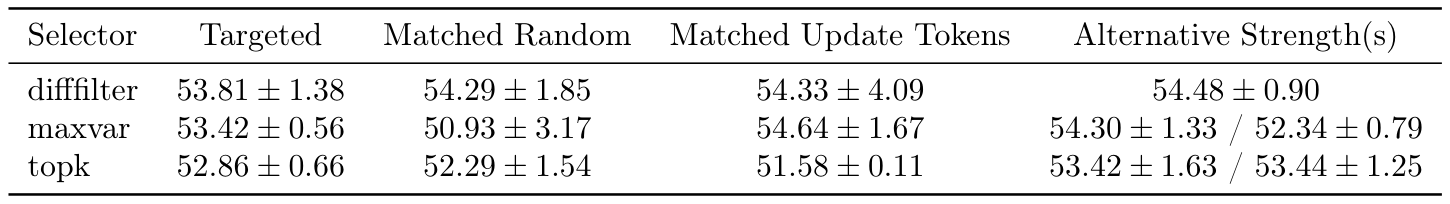
如果你打算就此得出「数据策略全是玄学」,附录 Table 9 会拦你一下。这个实验给每个 selector 配了三组对照,matched random 保留同样数量但随机挑,用来分离「定向性」这件事本身的价值;matched update tokens 补训到非零 update token 数追平 baseline,用来分离「更新体积」;alternative strength 放宽过滤带或改 keep 比例,用来分离「干预强度」。注意它是 Qwen2.5-7B-Instruct 上三 seed 的对照组,绝对分和主表不是一个尺度。
三组答案不一致。maxvar 和 topk 的定向筛选高于随机保留(53.42 对 50.93、52.86 对 52.29),difffilter 反而低于(53.81 对 54.29);补 update token 让 difffilter 和 maxvar 上升(54.33、54.64),却让 topk 下降(51.58)。没有任何单一机制能同时解释三个方法。
另一条被压在主文之外的事实我想单独拎出来。gfpo 和 baseline 在五个数学集上的 accuracy 几乎一模一样(72.21% 对 72.19%),但平均回复长度从 1568 字符降到 1497,每千字正确回答数从 0.461 升到 0.482。这个收益是真的,只是它不体现在 accuracy 上,你如果只报 Overall,就永远看不见它。
## 局限与我的判断
作者把边界划得很克制。这套结论只覆盖被检验的这些配方,**不构成方法无效的证明,也不等于统计意义上的等价**,300 步为主、部分 campaign 才跑到 1000 步,模型上限 14B,代码与 agent 这类 verifier 也不在测试范围内。
我的读法有两条。数据策略这条线现在更像调参面板而不是收益来源,同一个组内解率可以写成硬过滤,也可以写成连续权重,两条路都掉在噪声里;真有收益的那部分藏在长度和效率里,标准 accuracy 口径看不见,换句话说,指标不换,它就继续不存在。另一条比「A 方法没掉点」更可用,**评测里少测哪个域,比方法之间差多少分更能决定 leaderboard 的排名**。
如果你是做 RLVR 后训练的,这篇的落地价值可能就是四件便宜事,12 个匹配 seed、报配对区间而不是点估计、覆盖所有训练域再做汇总、跑之前先做一次格式 smoke test。这四件的成本都远低于多训一轮,而少做任何一件,都可能让一个不存在的方法连续两周待在你的内部排行榜顶端。
你们生产环境里除了 accuracy,效率或长度这类指标是按什么口径进报表的?评论区说说。
**论文信息**
**DataFlex-RL: An Evaluation Platform for RLVR Data Policies**
把 RLVR 的数据策略放进固定 GRPO 配方里做 12 配对 seed 对照,选样、加权、混合自适应相对均匀训练均无可信增益
- **机构**:北京大学 × 中国科学院大学 × 上海算法创新研究院 × 中关村学院
- **发表**:arXiv v1,2026-09(cs.LG,技术报告)
- **arXiv**:2609.06107
- **代码/项目**:https://github.com/haolpku/DataFlex-RL | 结果与原始数据 https://github.com/haolpku/DataFlex-RL/tree/main/results | 文档 https://haolpku.github.io/DataFlex-RL-Doc/
---
### 发布信息(随文)
**标题备选(带机构简称)**
1. 北大×国科大:RLVR 数据策略没一个打赢均匀采样
2. 591 次训练后,这层 RLVR 数据滤镜被摘掉了
3. 换 12 个 seed,你的 RLVR 冠军方案就换人
**封面(第 1 页,3:4)** 深色渐变底,左 40% 标题两行(第二行金黄),右 60% 放数字。主字 **+7.76**,副字 **0.97**,注一行小字「统一 GRPO 涨 7.76,九种数据策略均值跨度只有 0.97」,角标「北大 × 国科大 × 上海算法创新研究院」。背景不放任何介绍性文字。
**末页** 用上面「论文信息」文字块原样出卡,字段顺序不动,交给你自己的信息卡工具。
**标签** #论文解读 #RLVR #强化学习 #大模型后训练 #GRPO #算法工程师 #技术干货 #收藏级干货